
در ایران وقتی صبح سیستم را روشن میکنید و میبینید ایمیل باز نمیشود، معمولاً زیرلب چیزی نثار وضعیت اینترنت میکنید. بعد ابزار تغییر آیپی را وصل میکنید و اگر باز هم صفحه سفید ماند، میروید سراغ خاموش و روشن کردن مودم. اما پنجشنبه گذشته، مهندسان مایکروسافت با کابوسی روبهرو شدند که با هیچ خاموش و روشن کردنی حل نمیشد.
سامانههای ابری مایکروسافت ۳۶۵ در بیش از هفتاد کشور یکی پس از دیگری از کار افتادند؛ از اوتلوک و تیمز گرفته تا ابزارهای ثبتسازی و دستیار هوش مصنوعی. قطعی یک روز تمام طول کشید و هزاران شرکت، بانک، سازمان و بیمارستان را زمینگیر کرد. در این فروپاشی عظیم پای حمله سایبری پیچیده یا طغیان هوش مصنوعی در میان نبود؛ فقط زیرساخت ابری به مشکل خورده بود و هیچکس نمیتوانست سرورها را سر پا نگه دارد.
سراب فضای ابری؛ وقتی سرورهای ردموند از کار افتادند
عبارت «فضای ابری» یا کلود (Cloud) از کلیدواژههایی است که مدیران را مسحور میکند. کافی است بگویید قرار است زیرساخت شرکت را ببریم روی کلود تا همه خیالشان جمع شود که دیگر هیچ خطری اطلاعات شرکت را تهدید نمیکند.
اما فضای ابری در نهایت یعنی یک سری کامپیوتر و سرور فیزیکی است که در سولههای مایکروسافت، گوگل یا آمازون ردیف شدهاند و به هم کابل کشیدهاند. درست است که این شرکتها میلیاردها دلار خرج میکنند تا سرورها همیشه روشن بمانند، اما در نهایت با ماشین و نرمافزار طرفیم و ماشینها هم گاهی بدقلقی میکنند.
پنجشنبه گذشته این بدقلقی یقه مایکروسافت را گرفت. ظرف یک ساعت ریپورتهای خرابی از سرتاسر دنیا به ردموند سرازیر شد. کارمندان نمیتوانستند وارد اوتلوک (Outlook) شوند، ایمیل بفرستند یا ایمیلی دریافت کنند. جلسات کاری در نرمافزار «تیمز» مختل شده بود، اجازه دسترسی به فایلهای داخل «شیرپوینت» (SharePoint) با مشکل مواجه بود و حتی دستیار هوش مصنوعی پرمدعای شرکت یعنی «کوپایلوت» هم مات و مبهوت مانده بود و نمیتوانست اطلاعاتی تحویل بدهد.
اولین مهره دومینو چطور افتاد؟
در ریپورت مایکروسافت این نرمافزارها به صورت مستقل خراب نشده بودند. مقصر اصلی از کار افتادن «اکسچنج آنلاین» (Exchange Online) بود؛ همان زیرساخت اصلی که در پسزمینه، ایمیلها و تقویمهای سازمانی مایکروسافت را میچرخاند.
در جریان این اختلال اگر میخواستید در تیمز به یک همکار نوتیفیکیشن بدهید یا وارد تماس تصویری شوید، مشکلی نداشتید. اما به محض این که میخواستید جلسهای جدید در تقویم ثبت کنید یا از کوپایلوت میخواستید طبق ایمیلهای دیروز یک ریپورت بنویسد، سیستم قفل میکرد؛ چون تمام این کارها برای اجرا باید به «اکسچنج آنلاین» وصل میشدند و وقتی اکسچنج نبود، بقیه خدمتها هم مثل دومینو پشت سرش زمین میخوردند.
زخمی کهنه که با یک تغییر تازه سر باز کرد
وقتی خدمتهای شرکتی در ابعاد مایکروسافت یک شبانهروز مختل میشود، اولین حدس همه این است که یک گروه هکری مخوف کار دستشان داده است.
حدس دوم هم که این روزها خیلی طرفدار دارد، انداختن تقصیر گردن هوش مصنوعی است. خیلیها در فضای مجازی میگفتند لابد مایکروسافت برنامهنویسهایش را تعدیل کرده، کد برنامهنویسی را سپرده دست هوش مصنوعی و حالا سیستم به هم ریخته است. مایکروسافت روز جمعه صراحتاً آب پاکی را روی دست همه ریخت:
«مسئله فنی است و ارتباطی با حملات سایبری یا ایجنتهای هوش مصنوعی (AI Agents) ندارد. ریشه حادثه به مشکلی در جریان ارتقای قبلی ظرفیت شبکه بازمیگردد که پس از تغییر تنظیم کردن در روزهای اخیر نمایان شد.»
وقتی تیم فنی سراغ لاگها و ریپورتهای سیستم رفت تا ببیند چرا همهچیز قطع شده، متوجه نکته عجیبی شد. معمولاً وقتی یک سایت یا خدمت بزرگ از دسترس خارج میشود، علتش هجوم ناگهانی یوزران است؛ شبیه سایت کالابرگ که هنگام عضویت میلیونها نفر همزمان رویش کلیک میکنند و سرورها زیر فشار از کار میافتند. اما در ماجرای مایکروسافت ترافیک یوزران زیاد نشده بود و مشکل اینجا بود که سرورهای مایکروسافت یکییکی داشتند غیب میشدند.
وقتی نگهبان سامانه به پای خودش شلیک میکند
برای اینکه بفهمیم چطور سرورهای مایکروسافت یکی پس از دیگری از مدار خارج شدند، باید با دو مفهوم ساده در زیرساخت ابری آشنا شویم: خدمت «بررسی کردن سلامت» (Health Check) و «واکنش زنجیرهای» (Cascading Failure).
کسبوکارهای ابری بزرگ مثل مایکروسافت به یک سرور تکیه نمیکنند. آنها هزاران سرور دارند که کارها را بین خودشان تقسیم میکنند تا اگر یکی خراب شد، بقیه جورش را بکشند. کنترل و نظارت بر این سرورها در زیرساخت ابری بهعهده بخش «بررسی کردن سلامت» است.
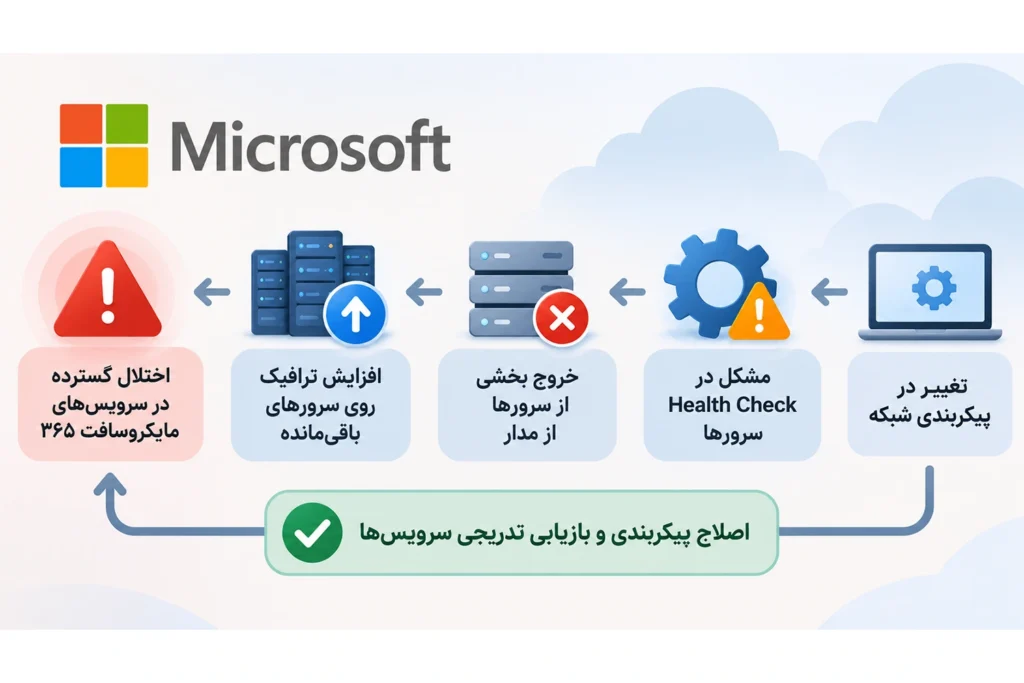
این سیستم خودکار مدام وضعیت سرورها را چک میکند و اگر دید سروری هنگ کرده یا درست جواب نمیدهد، آن را موقت از مدار خارج میکند تا کارها گیر نکند. پس از آن تغییر کذایی در شبکه، سرورها یکییکی در این آزمایش سلامت رد شدند و سیستم خودکار هم طبق وظیفهاش، آنها را از مدار خارج کرد تا ترافیکی به سمتشان نرود.
فروپاشی آبشاری سرورهای مایکروسافت
خدمت بررسی کردن سلامت همه درخواستهای یوزران را به سمت سرورهایی فرستاد که هنوز در شبکه روشن و سرپا بودند؛ اما چون ظرفیت باقیمانده پاسخگو نبود فاجعهای به نام فروپاشی آبشاری رخ داد.
روی هر سروری، یک فرآیند حیاتی هست که کارش برقراری «وصل شدن امن» با یوزر است؛ همان بخشی که چک میکند ارتباط شما با سرور رمزگذاریشده و امن باشد. وقتی بار سرورهای پاک کردنشده روی دوش سرورهای باقیمانده افتاد، فرآیند برقراری وصل شدن امن زیر فشار بیشازحد قفل کرد. سرورهایی که تا چند دقیقه پیش سالم بودند، زیر این بار جدید کم آوردند و از پردازش درخواستها دست کشیدند.
سرورهای جدید هم در آزمایش سلامت مردود شدند و از مدار بیرون رفتند. حالا همان حجم ترافیک اولیه باید روی سرورهای به مراتب کمتری تقسیم میشد؛ چرخهای معیوب که در هر دور، بخش بیشتری از زیرساخت را میبلعید.
چرا ریاستارت کردن جواب نمیداد؟
وقتی سیستم به این روز میافتد، منطقیترین کار این است که سرورهای خارجشده را ریاستارت کرد و به سر کار برگرداند. مهندسان مایکروسافت هم در ساعات اول تغییرات جدید را متوقف کردند، ترافیک را به بخشهای دیگر شبکه فرستادند و سرورهای ازکارافتاده را دوباره روشن کردند.
اما به محض اینکه ترافیک یوزران را سمت سرور هدایت میکردند، همان وصل شدن امن دوباره زیر حجم عظیم درخواستهای تلنبارشده خفه میشد و سرور در عرض چند دقیقه دوباره از دسترس خارج میشد.
ریاستارت کردن سرورها بدون کم کردن فشار ترافیک، مثل این بود که با یک لیوان آب بخواهید آتش یک انبار را خاموش کنید. مهندسان فهمیدند که مشکل با راهحلهای دمدستی حل نمیشود و باید چند کار را به صورت موازی و با احتیاط جلو ببرند:
- تغییر و بازطراحی موقت سیستم ارزیابی سلامت سرورها در بخشهایی از زیرساخت.
- اعمال محدودیت بر نوع ترافیکهای لاگینی و بازگرداندن پلکانی یوزران برای مطالعه رفتار سیستم.
- رولبک (Rollback) یا ریستور کردن تغییرات شبکه به وضعیتی که پیش از آغاز بحران وجود داشت.
- تلاش برای افزودن ماشینهای مجازی جدید که به خاطر ناهماهنگی در همگامسازی شبکه، ابتدا با شکست همراه شد.
این کارها کمی اوضاع را بهتر کرد، اما هیچکد برنامهام باعث نشد سیستم به یک ثبات دائمی برسد.
کلید نجات چه بود؟
ورق زمانی برگشت که مهندسان مایکروسافت یک پچ یا وصله اصلاحی را روی کامپوننت بالادستی مربوط به «احراز هویت و مسیریابی» اعمال کردند. با تجربهای که از قبل داشتند این بار دست به عصاتر عمل کردند.
اول پچ را روی بخش کوچکی از زیرساخت امتحان کردند. وقتی دیدند سرورها زیر بار ترافیک دوام میآورند و دوباره قطع نمیشوند، شروع کردند به پخش کردن این وصله در بقیهی دیتاسنترها؛ آن هم با اولویت دادن به کشورهایی که در حال وارد شدن به ساعات اوج کاری بودند.
بالا آمدن سرورها پایان ماجرا نبود. در طول بیش از ۲۰ ساعت قطعی، میلیونها ایمیل فرستادن شده بود که حالا در صف انتظار گیر کرده بودند. در خدمت ایمیل، یک قانون هست: اگر سرور تلاش کند ایمیلی را بفرستد و سرور مقصد تا یک زمان مشخص (مثلاً ۲۴ ساعت) جواب ندهد، ایمیل کنسل میشود و به فرستنده پیغام اشتباه برمیگردد.
مایکروسافت برای اینکه ایمیلهای مردم در این شلوغی از بین نرود، مهلت زمانی را به ۴۸ ساعت افزایش داد تا سرورها فرصت داشته باشند نوتیفیکیشنهای عقبافتاده را کمکم پردازش کنند و به دست گیرندهها برسانند. مایکروسافت خودش هم اعلام کرد که بالا آوردن تدریجی و مرحلهبهمرحله سرورها زمان رفع اختلال را طولانیتر کرده، اما تنها راهی بوده که میشد مطمئن شد سیستم دوباره وسط کار فرو نمیریزد.
هوش مصنوعی؛ تماشاچی دستبهسینه
همزمانی این حادثه با تب داغ وایب کد برنامهینگ و اتوماسیون کد برنامهنویسی باعث شد تا شایعاتی درباره اشتباهی ابزارهای هوش مصنوعی یا توسعه نرمافزار بدون نظارت انسانی سر زبانها بیفتد. هرچند موضعگیری قاطع مایکروسافت این ادعاها را رد کرد؛ اما هوش مصنوعی نه به عنوان مقصر، بلکه به عنوان یکی از قربانیان این حادثه ظاهر شد.
کانکتورهای خدمتهای OpenAI و آنتروپیک که به خدمتهای ابری مایکروسافت ۳۶۵ متصل بودند، همزمان دچار اشتباههای گسترده شدند. کلاد در مایکروسافت اوتلوک کار نمیکرد و ابزارهای تحلیلی قادر به خواندن تقویم و ایمیلها نبودند.
برای من و شمایی که در ایران زندگی میکنیم، یک روز قطع شدن خدمت خارجی، در مقایسه با قطعیها و اختلالاتی که قبلاً تجربه کردهایم شوکه کننده نیست. ما یاد گرفتهایم که همیشه یک راه دور زدن، یک نوتیفیکیشنرسان زاپاس و یک هارد اکسترنال دم دستمان داشته باشیم. اما در مقیاس جهانی این اختلال نشان داد که ابزارهای بهظاهر مستقل هوش مصنوعی و سازمانهای مدرن چقدر در برابر اشتباههای زیرساختی شکننده و بیدفاع هستند.
وقتی همه تخممرغها در یک سبد چیده میشوند
وقتی هزاران سازمان، از بانک و بیمارستان گرفته تا شرکتهای خصوصی، تمام کارهای روزمره و حتی ایمنیشان را به دست یک شرکت واحد میسپارند، یک نقطه آسیبپذیر مشترک به وجود میآید. کافی است در مایکروسافت یا آمازون تغییری کوچک با یک ارتقای قدیمی تداخل پیدا کند تا چرخ دندههای هزاران کسبوکار در کل دنیا از حرکت بایستد.
مایکروسافت وعده داده ریپورت دقیقتر این حادثه را منتشر کند تا معلوم شود چه چیزی این دومینو را راه انداخته است. اما تا همین جا هم درس اصلی این ماجرا روشن است: هیچ زیرساختی هرقدر هم که بزرگ و مدرن باشد، از اشتباه مصون نیست.
بنابراین داشتن ورژن پشتیبان و پلن B، به این معنی نیست که فایلهایتان را روی سرورهای بیشتری در همان شرکت ابری ثبت کنید. تابآوری واقعی یعنی اگر یک روز صبح آمدید سر کار و دیدید خدمتدهنده اصلیتان به هر دلیلی بالا نمیآید، همه کارهایتان روی زمین نماند.